将下面的 VIDEO PROMPT 转换成一张完整的故事板联系表。自动将可见动作分解为适当数量的关键帧。对于简单场景使用较少面板,对于…
分享链接 · https://openimages.ajiang.me/p/2074865750079373746/
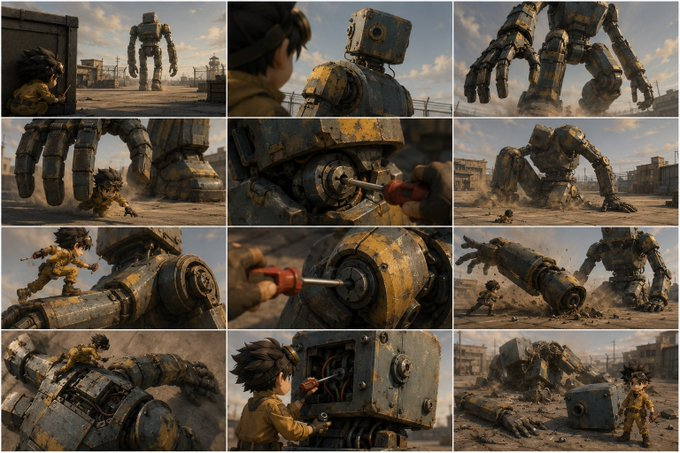
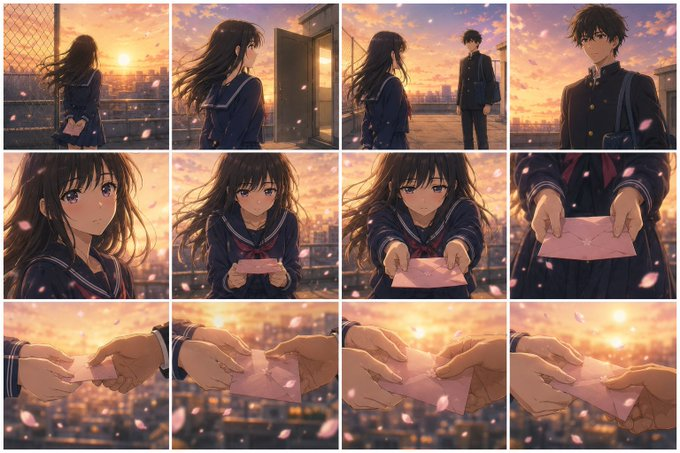
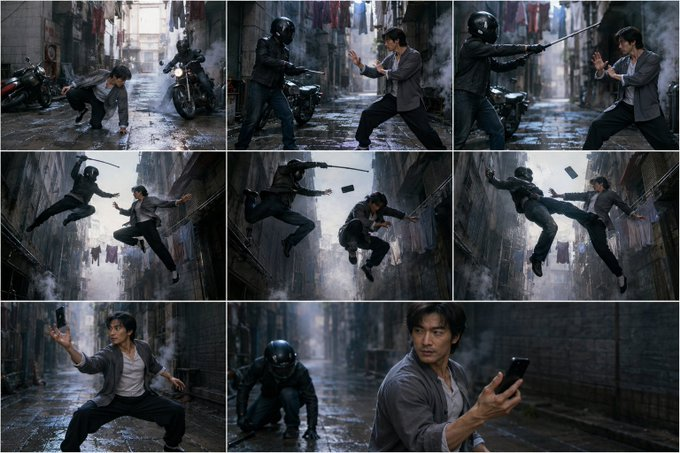
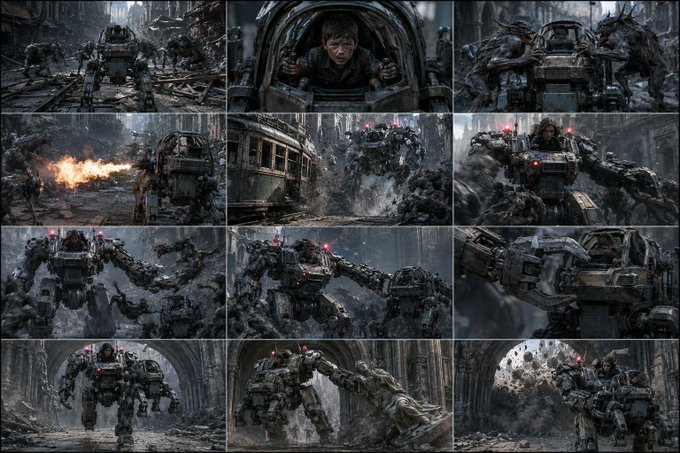
composition · multi-panelmood · dramaticquality_flags · multi-panel-layoutsubject_type · charactersubject_type · groupusage · concept-art
提示词(原文,逐字保留)
Turn the VIDEO PROMPT below into one finished storyboard contact sheet. Break the visible action into the appropriate number of keyframes automatically. Use fewer panels for simple scenes and more panels for complex action, prop continuity, transformations, multiple characters, or important reactions. Each panel must be a completed cinematic still from the same video world, not a rough sketch or written shot list.
Rules:
- Arrange panels in a clean adaptive grid, in chronological order from left to right and top to bottom.
- The overall sheet can use any aspect ratio needed to keep all panels readable.
- Preserve character identity, wardrobe, props, environment, lighting, style, screen direction, character count, and object continuity.
- Each panel shows one clear visible moment only. For an action, choose the strongest readable frame, usually contact, impact, reaction, transformation result, or final position.
- Do not invent new characters, props, actions, or locations.
- Do not add captions, panel numbers, arrows, dialogue, subtitles, sound cues, camera notes, or explanatory text.
VIDEO PROMPT:
-Enter your video prompt here-
中文译文
将下面的 VIDEO PROMPT 转换成一张完整的故事板联系表。自动将可见动作分解为适当数量的关键帧。对于简单场景使用较少面板,对于复杂动作、道具连续性、变形、多个角色或重要反应使用更多面板。每个面板必须是来自同一视频世界的完整电影静帧,而不是粗略草图或书面镜头列表。
规则:
- 以干净的自适应网格排列面板,按从左到右、从上到下的时间顺序。
- 整体表可以使用任何所需的宽高比,以保持所有面板可读。
- 保持角色身份、服装、道具、环境、灯光、风格、屏幕方向、角色数量和物体连续性。
- 每个面板仅显示一个清晰的可见时刻。对于动作,选择最强可读帧,通常是接触、冲击、反应、变形结果或最终位置。
- 不要发明新角色、道具、动作或地点。
- 不要添加字幕、面板编号、箭头、对话、字幕、声音提示、相机注释或解释性文本。
VIDEO PROMPT:
-Enter your video prompt here-
来源与署名
原文由 @Nas_tech_AI 发布在 X:查看原推文。 本页逐字保留原文并提供机器翻译的中文解读;版权归原作者所有。
同工具的更多提示词
- 一张完全荒诞、明亮、幽默的混合媒介照片,将真实人物摄影与光泽感十足的3D卡通元素相结合。一只小小的、圆滚滚的仓鼠蹲在一台专业电影摄影机顶部,它的小爪子紧紧抓着…@im_shahid7
- 一张蓝图风格的未来主义跑车技术图纸。包含跑车的前视图、侧视图和后视图的线条画、爆炸零件草图、零件装配图以及拆解组件的结构图。使用大量线条和测量数值标注每个零件…@marmaduke091
- 仅将上传的图片作为角色参考。保持相同的面部特征、发型、年龄、肤色、身体比例和整体外观。不要复刻原始的姿势、服装、构图、镜头角度或环境。 创建一个全新高端生活方…@mehvishs25
- https://t.co/0qRsl8vvEU 电影感的时尚摄影,场景设在纽约市一座高楼的屋顶上,天空为柔和漫射的阴天,密集的曼哈顿天际线向远处延伸。一位神情…@iamaiistudio
- https://t.co/zicYOIbkir 一张干净、编辑风格的胶片摄影作品,主体是一位魅力十足的日本或韩国女性,年龄大约二十岁中期,在一个新宿的自动售货…@iamaiistudio
- 凌乱的构图,杂乱的背景,卡通插画,深色浑浊的茶,普通的杯子,模糊的茶包细节,过多的道具,喧闹的排版,随机多彩的背景,低细节的液体,浓稠的咖啡状泡沫,混乱的涂鸦…@ou_zhen599